
Pendant longtemps, j’ai surveillé mes applications avec des fichiers de logs.
Quand un utilisateur signalait un problème, je cherchais une exception.
Quand une page devenait lente, je tentais de reproduire le problème.
Quand un appel vers une API externe échouait, je suivais manuellement les messages produits par plusieurs services.
Cette méthode fonctionne au début.
Elle montre vite ses limites dès qu’une application devient distribuée, qu’elle utilise plusieurs bases de données ou qu’elle échange avec des services externes.
J’ai donc mis en place OpenTelemetry.
Puis j’ai déployé Grafana, Tempo, Loki et Prometheus.
J’ai obtenu une plateforme très puissante.
J’ai aussi découvert une stack exigeante à configurer, à corréler, à sécuriser et à maintenir.
C’est ce parcours qui m’a conduit à créer BlazorTelemetry.
Mon objectif est simple : conserver les bénéfices d’OpenTelemetry dans mes projets ASP.NET Blazor, sans exploiter une plateforme distribuée complète lorsque le volume ne le justifie pas.
OpenTelemetry trouve naturellement sa place dans .NET
OpenTelemetry n’est pas un outil de visualisation
OpenTelemetry est un standard ouvert et indépendant des fournisseurs.
Il définit comment une application produit, structure, transporte et exporte sa télémétrie.
Il ne remplace pas un tableau de bord.
Il ne remplace pas non plus une base de données de logs.
Il fournit un langage commun entre l’application et les outils qui vont stocker ou afficher ses informations.
Je peux donc instrumenter une application une seule fois et changer ensuite de backend sans réécrire toute mon instrumentation.
OpenTelemetry organise principalement l’observabilité autour de trois signaux :
- les logs, qui décrivent des événements ;
- les traces, qui racontent le parcours complet d’une opération ;
- les métriques, qui mesurent l’évolution d’un système dans le temps.
La documentation OpenTelemetry présente aussi le baggage, qui transporte un contexte entre plusieurs services.
flowchart LR
    A[Application ASP.NET Blazor] --> L[Logs<br/>Que s'est-il passé ?]
    A --> T[Traces<br/>Où le temps a-t-il été passé ?]
    A --> M[Métriques<br/>Le système se dégrade-t-il ?]
    L --> C[Contexte commun<br/>service, environnement, TraceId, SpanId]
    T --> C
    M --> C
    C --> O[Backend d'observabilité]
Pourquoi l’intégration avec .NET est naturelle
.NET possède déjà les briques techniques nécessaires.
ILogger structure les logs.
Activity et ActivitySource portent les traces.
Meter et System.Diagnostics.Metrics produisent les métriques.
ASP.NET Core, Kestrel, HttpClient, Entity Framework Core et le runtime .NET exposent déjà beaucoup d’informations.
Je n’ai donc pas besoin d’ajouter un chronomètre et un message de log autour de chaque ligne de code.
Les bibliothèques d’instrumentation captent une grande partie du trafic automatiquement.
La documentation .NET sur OpenTelemetry décrit bien cette complémentarité entre les signaux produits par le runtime, les bibliothèques et le code métier.
Dans une application ASP.NET Core, je peux suivre une requête entrante, son appel SQL et son appel HTTP sortant dans une même trace.
Si un log est produit pendant cette opération, son TraceId et son SpanId permettent de le rattacher au bon parcours.
sequenceDiagram
    actor U as Utilisateur
    participant B as Blazor
    participant A as API ASP.NET Core
    participant D as Entity Framework
    participant P as API partenaire

    U->>B: Clique sur Valider
    B->>A: POST /orders
    A->>D: Enregistre la commande
    D-->>A: Résultat SQL
    A->>P: Crée le paiement
    P-->>A: Réponse du prestataire
    A-->>B: Résultat HTTP
    Note over B,P: Un même TraceId relie les opérations
Ce que chaque signal m’apporte
Une métrique me dit qu’un problème existe.
Par exemple, le temps de réponse au 95e percentile augmente depuis dix minutes.
Une trace me montre où ce temps est consommé.
Je peux voir que la base répond vite, mais qu’un appel HTTP externe dure deux secondes.
Un log me donne ensuite le détail précis.
Il peut contenir le code d’erreur du prestataire, le nom de l’opération et le contexte métier utile.
Je ne les oppose donc pas.
Je les utilise ensemble.
flowchart TD
    M[Métrique anormale<br/>latence ou erreurs] --> T[Trace lente ou en échec]
    T --> S[Span responsable]
    S --> L[Logs corrélés]
    L --> R[Cause comprise]
Cette corrélation est, pour moi, le bénéfice principal d’OpenTelemetry.
Elle remplace une recherche approximative par heure, serveur et texte par une navigation fondée sur un identifiant commun.
Les traces et les métriques importantes pour un projet ASP.NET Blazor
Tout collecter n’est pas une stratégie.
Un système d’observabilité doit répondre à des questions simples.
Mon application répond-elle ?
Répond-elle assez vite ?
Quel composant provoque les erreurs ?
Les circuits Blazor Server restent-ils stables ?
Le runtime manque-t-il de ressources ?
Les requêtes HTTP entrantes
Je commence par les requêtes reçues par ASP.NET Core.
Je surveille au minimum :
- le nombre de requêtes par route ;
- la durée moyenne, mais surtout les percentiles
p50,p95etp99; - le nombre de requêtes actives ;
- la répartition des statuts
2xx,4xxet5xx; - les routes qui ne correspondent à aucun endpoint ;
- les requêtes mises en attente ou rejetées.
La moyenne seule masque souvent le problème.
Une majorité de réponses rapides peut cacher quelques requêtes extrêmement lentes.
Le percentile p95 me montre ce que vivent les 5 % d’utilisateurs les moins bien servis.
ASP.NET Core expose notamment http.server.request.duration et http.server.active_requests. La référence des métriques HTTP ASP.NET Core documente aussi les connexions Kestrel, le routage et la limitation de débit.
Les traces des opérations lentes ou en erreur
Une trace utile ne se limite pas à la requête HTTP.
Je veux voir ses enfants :
- les requêtes SQL et leur durée ;
- les appels
HttpClient; - les traitements métier importants ;
- les passages dans les handlers ;
- les opérations asynchrones ;
- les exceptions et leur statut ;
- le service et l’environnement concernés.
Je surveille particulièrement les traces en erreur et les traces lentes.
Je conserve aussi les relations parent-enfant.
Elles permettent de distinguer une lenteur propre au serveur d’une attente causée par une dépendance.
flowchart LR
    R[POST /orders<br/>820 ms] --> H[Handler CreateOrder<br/>790 ms]
    H --> E[EF Core INSERT<br/>35 ms]
    H --> X[HttpClient paiement<br/>710 ms]
    X --> F[Réponse 503<br/>prestataire externe]
Dans cet exemple, optimiser la requête SQL ne changera presque rien.
La trace évite donc de corriger le mauvais composant.
Les appels HTTP sortants
Une application Blazor dépend souvent d’autres services.
Je surveille la durée des appels, les destinations, les erreurs DNS, les délais d’attente et les codes de réponse.
Les métriques http.client.request.duration, http.client.active_requests et dns.lookup.duration permettent de détecter un problème qui ne vient pas directement de mon code. Elles sont décrites dans la référence des métriques System.Net.
Entity Framework Core
Je veux connaître :
- la durée des commandes ;
- le nombre de lectures et d’écritures ;
- les échecs ;
- les opérations simultanées ;
- les requêtes anormalement fréquentes.
Je reste prudent avec les commandes SQL complètes.
Elles peuvent contenir des données sensibles.
Dans BlazorTelemetry, les instructions SQL ne sont donc pas exportées par défaut.
Je préfère commencer par le type d’opération, sa durée et son résultat.
Les circuits et les interactions Blazor Server
Une page Blazor Server ne se résume pas à une requête HTTP classique.
Elle vit dans un circuit persistant, généralement transporté par SignalR.
Je surveille donc :
- le nombre de circuits actifs ;
- le nombre de circuits connectés ;
- la durée de vie des circuits ;
- les connexions SignalR ;
- les navigations ;
- les événements utilisateur lents ;
- les erreurs pendant le cycle de vie d’un composant.
.NET 10 expose des métriques dédiées, dont aspnetcore.components.circuit.active, aspnetcore.components.circuit.connected et aspnetcore.components.circuit.duration. Microsoft décrit aussi les activités de trace liées au cycle de vie du circuit, à la navigation et aux événements dans ses recommandations de performance Blazor.
Ces signaux sont importants.
Une API peut sembler rapide alors que l’utilisateur subit des reconnexions répétées ou un événement de composant trop long.
Le runtime .NET et le serveur
Je complète la vue applicative avec les ressources du processus :
- CPU ;
- mémoire et working set ;
- allocations ;
- collections du garbage collector ;
- taille du tas ;
- saturation du thread pool ;
- exceptions ;
- connexions Kestrel actives ou en attente.
La référence des métriques du runtime .NET couvre le GC, le JIT, le thread pool, les exceptions, le CPU et la mémoire.
Je ne regarde pas ces courbes seules.
Je les rapproche de la charge HTTP et des traces lentes.
Une hausse de mémoire pendant un pic de trafic n’a pas la même signification qu’une hausse continue lorsque le trafic reste stable.
Les métriques métier
Les métriques techniques ne disent pas tout.
Je peux avoir une application parfaitement rapide qui ne traite plus aucune commande.
J’ajoute donc quelques métriques métier :
- commandes créées ;
- paiements acceptés ou refusés ;
- imports terminés ou échoués ;
- messages en attente ;
- traitements métier actifs ;
- durée d’un handler critique.
Je limite le nombre d’attributs.
Je n’utilise jamais un identifiant de commande, une adresse e-mail ou un TraceId comme dimension de métrique.
Une dimension à très forte cardinalité fait exploser le nombre de séries et dégrade rapidement le stockage.
La stack Grafana complète : puissante, mais exigeante
Ma première architecture reposait sur les composants classiques de l’écosystème Grafana.
Grafana affichait les données.
Tempo stockait les traces.
Loki stockait les logs.
Prometheus stockait les métriques.
Un collecteur recevait les données OpenTelemetry et les distribuait vers les bons backends.
flowchart LR
    A[Applications .NET] -->|OTLP| C[Collector ou Alloy]
    C --> T[Tempo<br/>traces]
    C --> L[Loki<br/>logs]
    C --> P[Prometheus<br/>métriques]
    T --> G[Grafana]
    L --> G
    P --> G
    G --> U[Développeur]
Sur le papier, le découpage est propre.
Chaque composant a une responsabilité claire.
La stack sait absorber de gros volumes et évoluer vers une architecture distribuée.
Mais chaque flèche du schéma est aussi une configuration, un port, un protocole, un secret et une panne possible.
La collecte est seulement la première étape
J’ai dû choisir entre OTLP gRPC et OTLP HTTP/protobuf.
J’ai dû exposer les bons ports.
J’ai dû configurer TLS, le proxy inverse, les limites de taille, les délais, les files d’attente et les reprises après erreur.
Une application pouvait annoncer qu’elle exportait sa télémétrie alors que le collecteur rejetait silencieusement une partie des données.
Un test TCP réussi ne prouvait pas que le protocole OTLP fonctionnait de bout en bout.
La corrélation Tempo et Loki n’est pas automatique
Je voulais partir d’une trace lente et ouvrir immédiatement ses logs.
Je voulais aussi partir d’un log d’erreur et retrouver sa trace.
Pour obtenir ce résultat, les logs devaient contenir le bon identifiant.
Les noms de champs devaient être cohérents.
Les labels Loki devaient correspondre aux attributs Tempo.
La source Tempo devait connaître Loki.
La source Loki devait savoir extraire le TraceId et créer le lien inverse.
flowchart LR
    S[Span Tempo] -->|service.name + TraceId| Q[Requête Loki]
    Q --> L[Logs de la trace]
    L -->|champ TraceId extrait| T[Retour vers Tempo]
La documentation Grafana sur la corrélation entre Tempo et Loki le montre bien : la configuration doit être faite dans les deux sens.
Une différence entre traceID, trace_id et traceId suffit à casser le lien.
Un mauvais mapping de service.name peut ne produire aucune erreur visible.
J’ai aussi appris à ne pas utiliser le TraceId comme label Loki.
Sa cardinalité est beaucoup trop élevée.
Je le conserve comme métadonnée structurée ou comme champ filtrable.
La rétention est une fonction de production
Les logs ne s’arrêtent jamais seuls.
Sans politique de rétention, le disque finit par se remplir.
Une fois le disque saturé, les conséquences dépassent l’observabilité.
Les écritures échouent.
Les conteneurs redémarrent.
Le serveur peut devenir instable.
Avec Loki, la rétention passe notamment par le Compactor. La documentation officielle de Loki précise que la rétention n’est pas activée par défaut et que, sans cette configuration, les logs continuent de vivre.
J’ai donc dû régler :
- la durée de conservation des logs ;
- la durée de conservation des traces ;
- la rétention des métriques ;
- le nettoyage de l’index ;
- la taille des volumes ;
- les politiques du stockage objet ;
- les sauvegardes ;
- les alertes sur l’espace disponible.
La bonne valeur dépend du volume.
Conserver sept jours de logs très verbeux peut coûter plus que conserver plusieurs mois de métriques agrégées.
Construire un bon dashboard est long et fastidieux
Installer Grafana ne produit pas automatiquement un dashboard utile.
Je dois concevoir chaque panneau, choisir la bonne période, calculer les bons percentiles et vérifier les résultats avec de vraies données.
Ce travail est très long.
Il est aussi fastidieux.
Il faut également apprendre plusieurs langages de requêtage spécialisés :
- PromQL pour interroger les métriques Prometheus ;
- LogQL pour rechercher et agréger les logs Loki ;
- TraceQL pour retrouver et analyser les traces Tempo.
Chacun possède sa syntaxe, ses fonctions et ses pièges.
Une mauvaise agrégation peut masquer un incident.
Un regroupement trop détaillé peut créer des milliers de séries.
Une fenêtre de temps mal choisie peut faire disparaître un pic important.
flowchart LR
    P[PromQL<br/>métriques] --> D[Dashboard Grafana]
    L[LogQL<br/>logs] --> D
    T[TraceQL<br/>traces] --> D
    D --> V[Vue opérationnelle cohérente]
Je dois ensuite maintenir ces requêtes quand une route, un service ou un environnement change.
Le dashboard devient donc un produit à part entière.
Il faut le concevoir, le tester et le faire évoluer.
La sécurité multiplie le travail d’exploitation
La stack contient plusieurs applications, plusieurs images Docker et plusieurs interfaces d’administration.
Elle expose aussi des endpoints d’ingestion.
Chaque composant possède ses dépendances, sa configuration et son cycle de publication.
Les scanners de sécurité remontent donc régulièrement des vulnérabilités dans les images de base, les bibliothèques ou les composants eux-mêmes.
Je dois alors déterminer si la faille est réellement exploitable dans mon déploiement.
Je dois mettre à jour sans casser les formats de stockage, les dashboards ou la corrélation.
Je dois ensuite tester toute la chaîne.
Une simple mise à jour devient parfois une opération de maintenance complète.
Je dois aussi protéger les données observées.
Un log peut contenir une adresse e-mail.
Une URL peut contenir un jeton.
Une commande SQL peut exposer une donnée métier.
Un header peut contenir une clé.
La sécurité commence donc avant Grafana.
Elle commence dans le choix des données exportées.
Un véritable parcours du combattant
J’ai fini par obtenir une stack stable.
Elle était puissante.
Elle permettait des requêtes avancées, une forte montée en charge et une séparation claire des stockages.
Mais sa maintenance n’était pas proportionnée à tous mes projets.
Pour quelques applications Blazor et un volume modéré, j’exploitais une petite plateforme distribuée uniquement pour répondre à quelques questions récurrentes.
Je passais trop de temps à surveiller mon outil de surveillance.
BlazorTelemetry : mon dashboard dédié à ASP.NET Blazor
J’ai donc changé de direction.
Je n’ai pas abandonné OpenTelemetry.
Au contraire, je l’ai conservé comme contrat d’entrée.
J’ai seulement simplifié tout ce qui se trouve derrière.
BlazorTelemetry reçoit les logs, les traces et les métriques au format OTLP.
Il les stocke dans SQLite.
Il les affiche dans une interface Blazor.
Il applique la rétention.
Il évalue les alertes.
Tout cela tient dans un seul service.
Le projet est open source.
Son code source est disponible sur GitHub : github.com/appliman/blazortelemetry.
flowchart LR
    A[Applications ASP.NET Blazor] -->|OTLP gRPC ou HTTP/protobuf| B[BlazorTelemetry]
    B --> Q[File d'ingestion bornée]
    Q --> W[Écriture asynchrone]
    W --> S[(SQLite)]
    S --> D[Dashboard Blazor]
    S --> R[Rétention]
    S --> E[Moteur d'alertes]
    E --> N[Webhook / SMTP / ntfy]
Cette architecture vise une instance unique et un volume raisonnable.
Elle ne cherche pas à remplacer Grafana, Tempo, Loki et Prometheus dans une grande plateforme à haute disponibilité.
Elle répond à un autre besoin : surveiller simplement quelques applications .NET.
Une vue opérationnelle immédiate
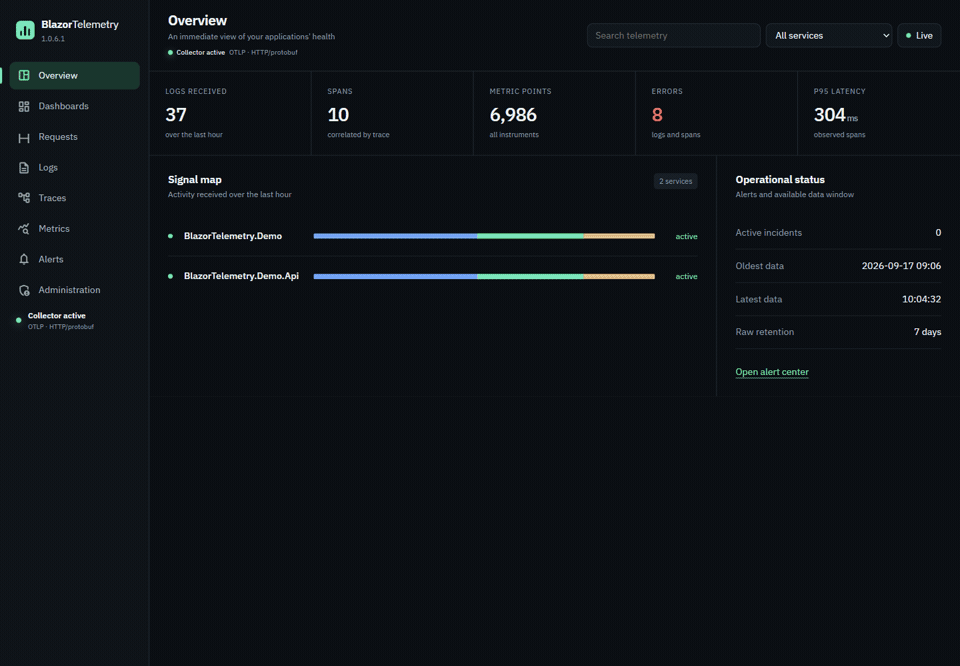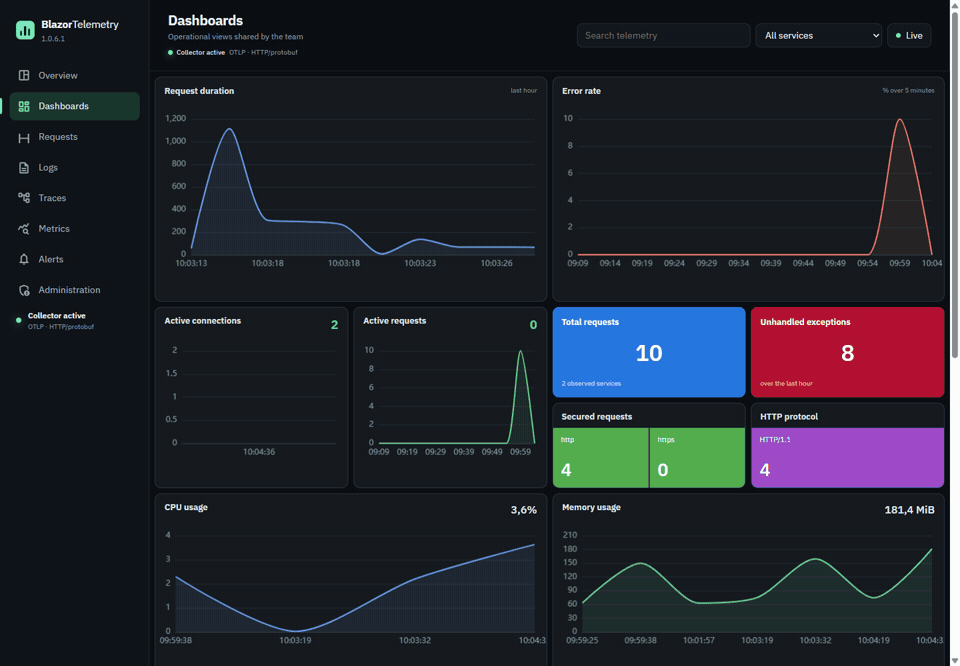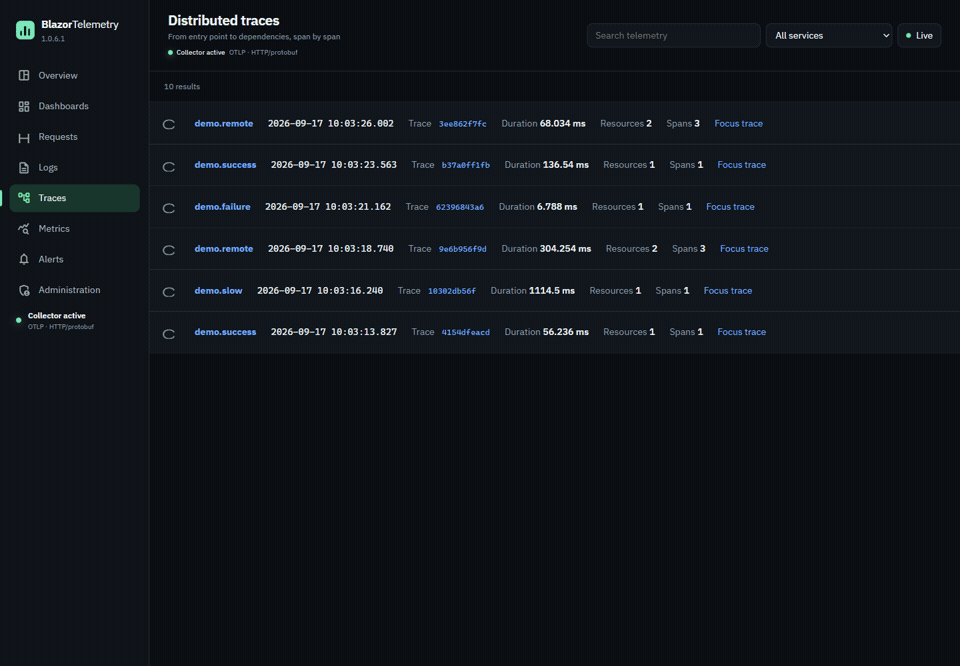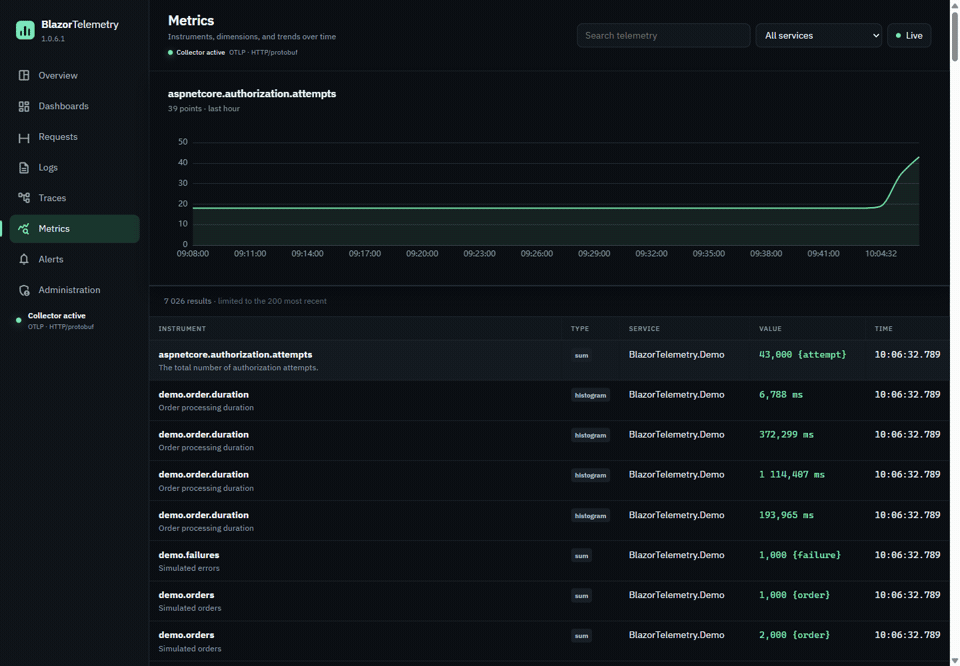
La page principale me montre les services actifs, les erreurs, les requêtes et l’activité récente.
Je peux filtrer par application et par période.
Je peux suivre les méthodes HTTP, les statuts, les durées et les opérations Entity Framework.
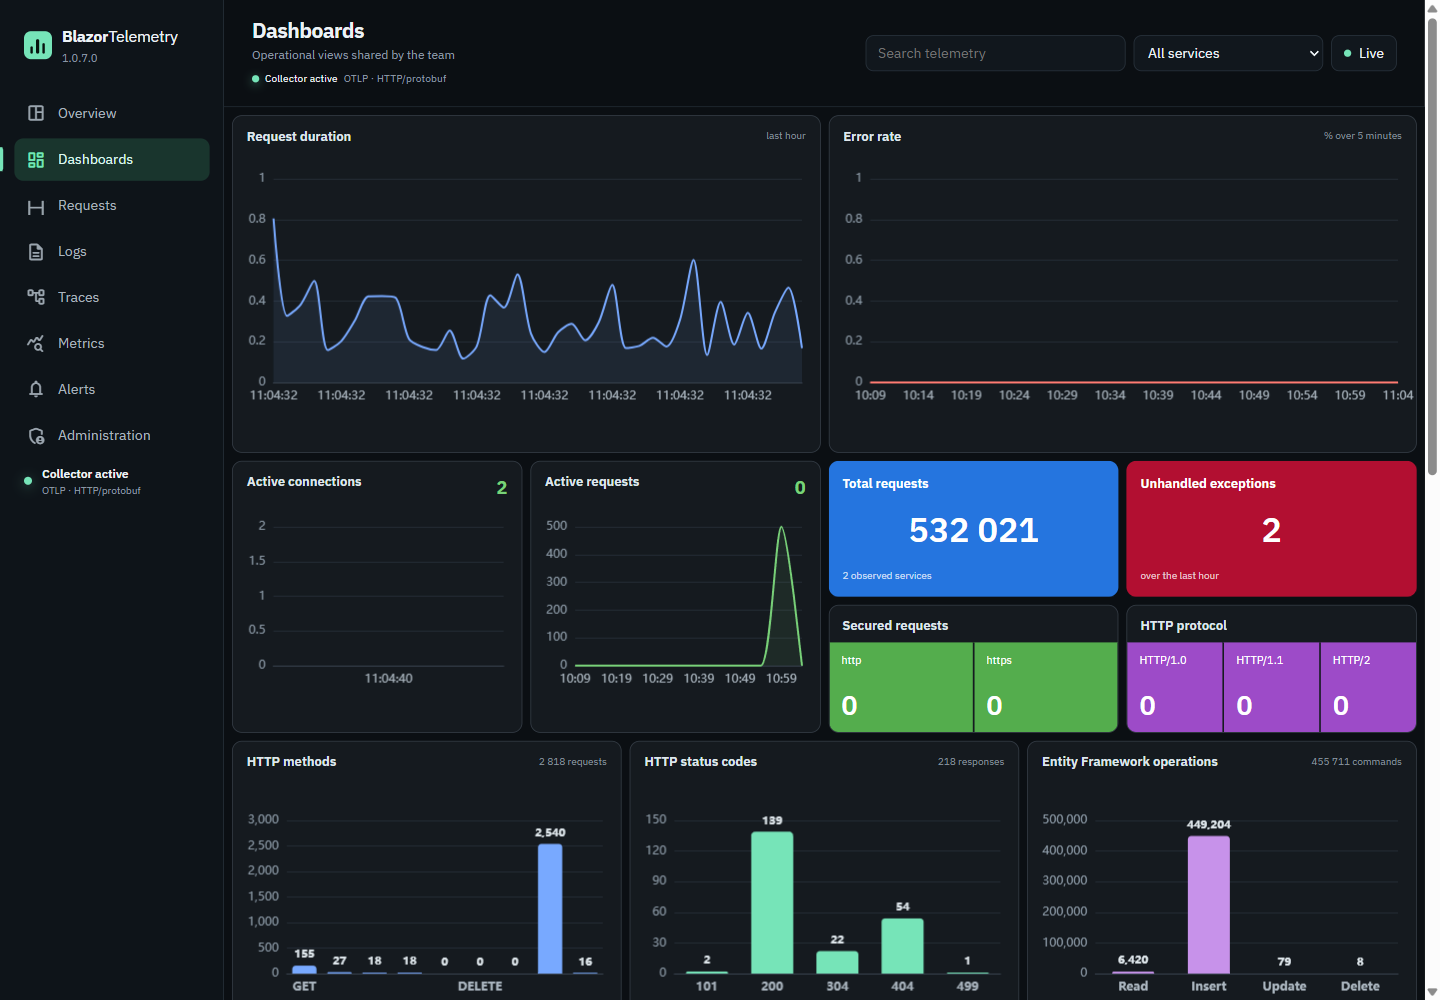
Je voulais pouvoir comprendre la situation sans écrire d’abord une requête PromQL, LogQL ou TraceQL.
Le dashboard ne remplace pas ces langages pour les analyses très avancées.
Il accélère les investigations quotidiennes.
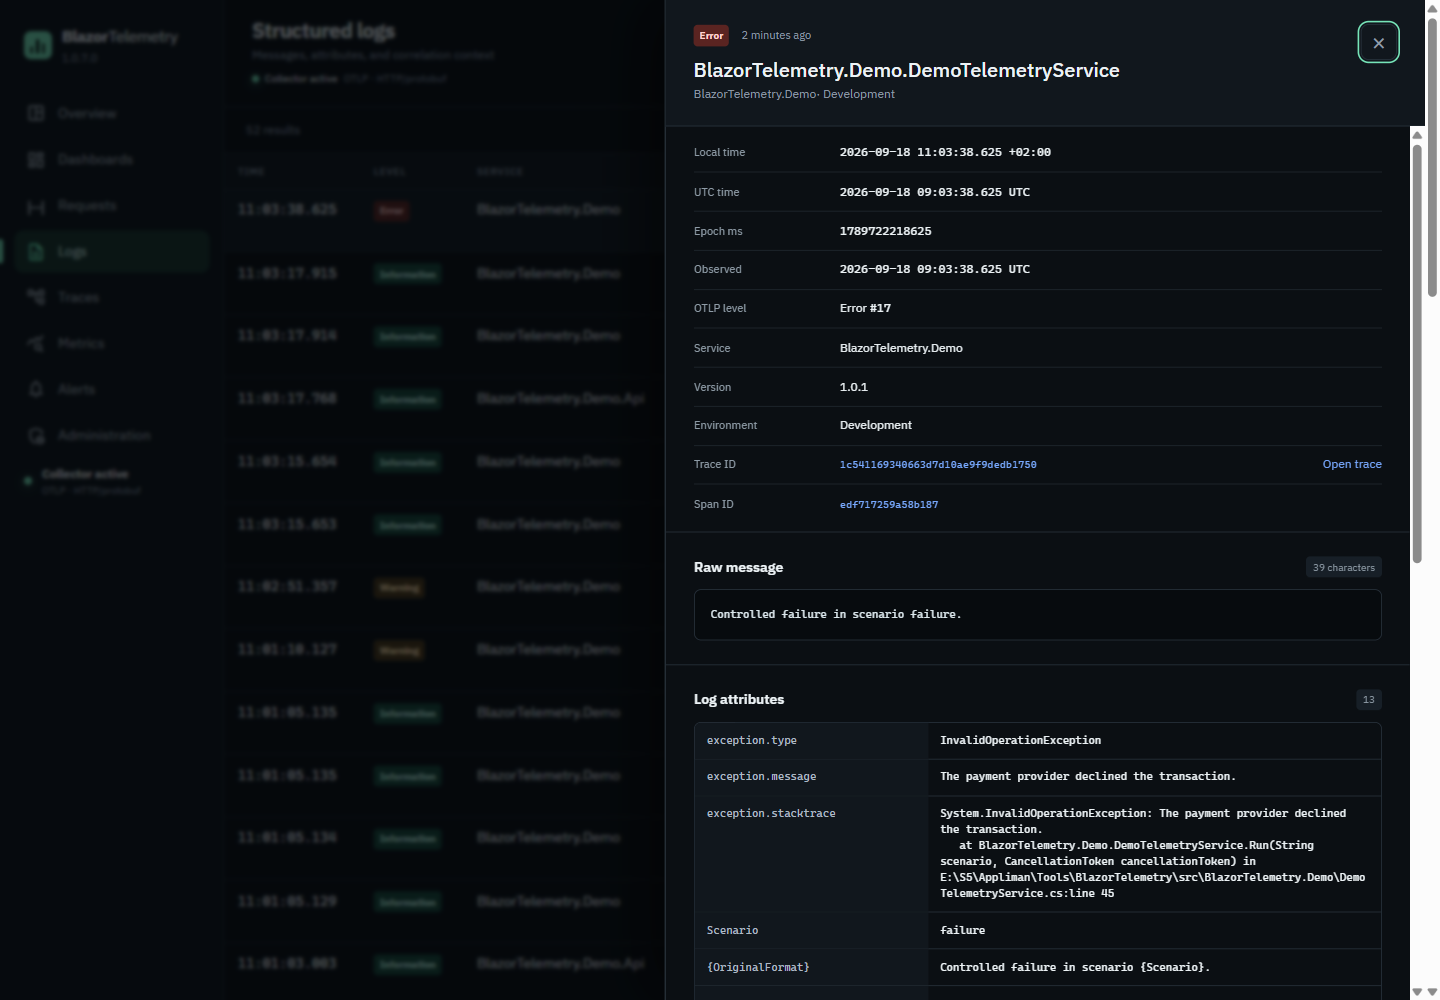
Des logs structurés reliés aux traces
Quand j’ouvre un log, je retrouve son niveau, son service, son environnement, ses attributs et ses identifiants de corrélation.
Si le log possède un TraceId et un SpanId, je peux ouvrir directement la trace correspondante.
La trace est présentée sous forme de chronologie.
Un clic sur une ligne ouvre le détail dans un panneau latéral.
Je conserve le contexte visuel tout en inspectant les attributs du span.
Une interface utilisable sur mobile
Je consulte parfois l’état d’un service sans être devant mon poste de développement.
J’ai donc prévu une navigation compacte et des filtres adaptés aux petits écrans.
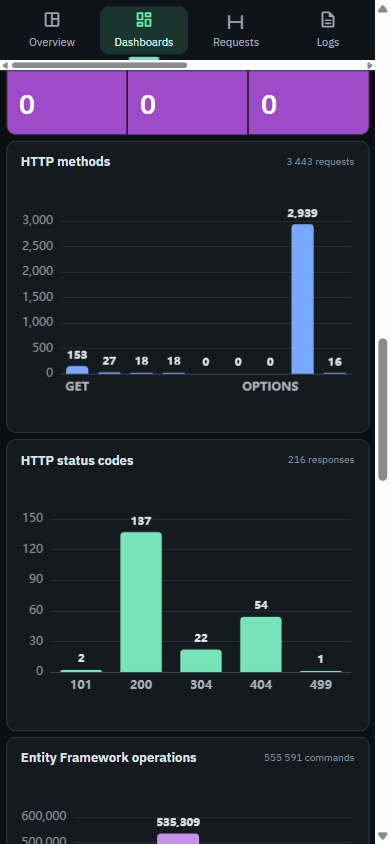
Cette vue mobile n’a pas vocation à remplacer une analyse complète.
Elle permet de vérifier rapidement un incident, une hausse d’erreurs ou l’état d’une application.
Une visite rapide du produit
L’animation suivante montre le passage de la vue générale aux logs, aux traces et aux métriques.
Comment je déploie BlazorTelemetry
Je peux l’exécuter avec Docker.
Je commence par récupérer le projet :
git clone https://github.com/appliman/blazortelemetry.git
cd blazortelemetry/src
Je crée ensuite un fichier .env local :
BLAZOR_TELEMETRY_ADMIN_EMAIL=admin@example.com
BLAZOR2FA_SECRET_KEY=replace-with-a-long-random-secret
Je démarre le service :
docker compose up --build -dLes données de télémétrie et les clés ASP.NET Core Data Protection sont conservées dans un volume Docker.
L’authentification du dashboard utilise un code TOTP.
Après le démarrage, j’ouvre /login/qr-code, je scanne le QR code avec mon application d’authentification, puis je me connecte sur /login.
Comment je connecte une application ASP.NET Blazor
J’installe le client préconfiguré :
dotnet add package BlazorTelemetryClientJe définis le nom du service et l’endpoint OTLP :
OTEL_SERVICE_NAME=my-blazor-app
OTEL_EXPORTER_OTLP_ENDPOINT=http://localhost:4317
OTEL_EXPORTER_OTLP_PROTOCOL=grpc
Puis j’ajoute une seule inscription dans Program.cs :
using BlazorTelemetry.Client;

var builder = WebApplication.CreateBuilder(args);

builder.Services.AddBlazorTelemetry();
Cette configuration active les logs structurés, les traces et métriques ASP.NET Core, la télémétrie HttpClient, les métriques du runtime et l’instrumentation Entity Framework Core.
Je peux ensuite ajouter mes propres ActivitySource, mes propres Meter et mes attributs de ressource :
builder.Services.AddBlazorTelemetry(options =>
{
    options.ServiceName = "my-blazor-app";
    options.ServiceVersion = "1.0.0";
    options.DeploymentEnvironment = builder.Environment.EnvironmentName;

    options.AddSource("MyCompany.MyApplication");
    options.AddMeter("MyCompany.MyApplication");
    options.AddResourceAttribute("service.namespace", "commerce");
});
BlazorTelemetry accepte aussi OTLP HTTP/protobuf sur /v1/logs, /v1/traces et /v1/metrics.
Je garde gRPC comme transport par défaut.
Comment je maîtrise la rétention
La simplicité ne dispense pas de limiter le stockage.
Je configure séparément les données brutes et les métriques :
{
  "BlazorTelemetry": {
    "ConnectionString": "Data Source=Data/telemetry.db",
    "RawRetentionDays": 7,
    "MetricRetentionDays": 30,
    "MaximumDatabaseBytes": 10737418240
  }
}
Dans cet exemple, les logs et les traces brutes sont conservés sept jours.
Les points de métriques sont conservés trente jours.
La base possède un budget maximal de 10 Gio.
Le nettoyage est automatique.
Je conserve ainsi une limite simple à comprendre et à surveiller.
Comment je sécurise l’ingestion
Par défaut, BlazorTelemetry n’exige pas de clé d’ingestion.
Dans ce mode, je limite l’accès aux endpoints OTLP au niveau du serveur ou du proxy inverse, avec une liste d’adresses IP autorisées.
Si le réseau ne suffit pas, je peux activer une clé :
BLAZOR_TELEMETRY_REQUIRE_INGESTION_KEY=true
OTEL_EXPORTER_OTLP_HEADERS=X-BlazorTelemetry-Key=replace-with-the-generated-key
Je ne place jamais cette clé dans le dépôt Git.
Derrière Traefik, je configure aussi les forwarded headers avant le middleware BlazorTelemetry et je ne fais confiance qu’aux proxies connus.
Enfin, je sélectionne les données envoyées.
Je n’exporte pas les cookies, les jetons, les headers complets, les corps sensibles, les adresses e-mail ou les identifiants métier bruts.
Ce que je gagne avec cette approche
Je conserve un standard ouvert.
Mes applications parlent toujours OpenTelemetry.
Je peux donc les rediriger plus tard vers une autre plateforme.
Je gagne aussi une exploitation beaucoup plus simple :
- un service à déployer ;
- une base SQLite à sauvegarder ;
- une seule interface ;
- une politique de rétention lisible ;
- une corrélation déjà intégrée ;
- des vues pensées pour ASP.NET Core et Blazor ;
- des alertes et des notifications dans le même produit.
Je perds volontairement certaines capacités d’une stack distribuée.
BlazorTelemetry n’est pas mon choix pour des milliers de services, un très fort débit, une haute disponibilité stricte ou des requêtes analytiques très avancées.
Dans ces cas, Grafana, Tempo, Loki et Prometheus restent de meilleurs outils.
Pour une petite équipe qui surveille quelques applications ASP.NET Blazor, le compromis est différent.
Je veux voir rapidement ce qui se passe.
Je veux retrouver une trace depuis un log.
Je veux identifier une route lente.
Je veux maîtriser l’espace disque.
Je ne veux pas exploiter une plateforme complète pour y parvenir.
Conclusion
OpenTelemetry a profondément amélioré ma manière de diagnostiquer mes applications .NET.
Les logs me donnent le détail.
Les traces me donnent le parcours.
Les métriques me donnent la tendance.
Leur corrélation transforme réellement l’investigation.
La stack Grafana complète reste une excellente solution.
Elle est robuste, extensible et adaptée aux grandes architectures.
Mais elle demande du temps, de l’expertise et une maintenance continue.
Avec BlazorTelemetry, j’ai choisi une autre échelle.
Je garde OpenTelemetry.
Je garde les trois signaux.
Je garde la corrélation et la rétention.
Je réduis l’infrastructure à un seul service pensé pour mes projets ASP.NET Blazor.
C’est cette simplicité qui me permet enfin de consacrer plus de temps à mes applications qu’à leur stack d’observabilité.
Aucun commentaire publié pour le moment.
Ajouter un commentaire